Ich ließ ChatGPT und Claude Cowork an meinen Dateien arbeiten - nur eine machte mich nervös.
Wie verhält sich ChatGPT im Vergleich zu Claude Cowork bei der Automatisierung am Desktop? Meine Tests zeigen ähnliche Ergebnisse und ähnliche Stärken - außerdem gibt es einen wichtigen Grund, warum Claude im Moment deutlich sicherer erscheint.

Wichtigste Erkenntnisse
- ChatGPT hat Zeit bei der mühsamen Dateibereinigung gespart.
- Das Projekt hat 11 % der Kapazität meines 20-Dollar-Plus-Plans genutzt.
- Fehlende Berechtigungsabfragen bleiben das größte Ausschlusskriterium.
ChatGPT Work wurde letzte Woche veröffentlicht. Es ist sowohl im Browser für cloudbezogene Aufgaben als auch in der ChatGPT-Desktop-App für auf dem Desktop auszuführende Aufgaben verfügbar.
Leider ersetzt die neue ChatGPT-App einen Großteil der bisherigen Funktionen von ChatGPT Desktop durch „agentische“ Aufgaben aus Codex und Work. Anstatt weiterhin über das Entfernen meiner Lieblingsfunktionen in ChatGPT Desktop zu schimpfen, beschloss ich herauszufinden, was ChatGPT Work eigentlich kann. Ich bin schließlich jemand, der stets konstruktiv handelt. Außerdem bat mich mein Redakteur darum, das zu tun.
Es wäre eine beängstigende Vorstellung, eine ungetestete, halluzinationsanfällige KI auf meinem Desktop freizulassen. Deswegen beschloss ich, ihr einen der ersten kontrollierten Tests zu geben - genau wie ich es damals mit Claude Cowork gemacht habe, als dieses noch in der Forschungsphase war. Angesichts der Ergebnisse von ChatGPT Work bin ich allerdings noch nicht bereit, sie an anderen Desktop-Projekten einzusetzen.
Und damit: Lasst uns loslegen.
Definition des Projekts
Das Projekt ist ziemlich einfach: Die PDF-Dateien in meinem Downloads-Ordner sortieren. Ich verwende ein Mac-Programm namens Hazel, das Dateien aus dem Downloads-Ordner automatisch in Unterordner sortiert - je nach Dateityp. Die Dateien verbleiben drei Tage lang im Downloads-Ordner und werden anschließend verschoben. Somit wird eine vor drei Tagen heruntergeladene PDF-Datei in einen großen „PDFs“-Ordner verschoben.
Da ich ein vorsichtiger Mensch bin, machte ich zuerst eine Kopie meines PDF-Ordners in einem tmp-Verzeichnis - genauso wie ich es getan hatte, als ich das Programm mit Cowork testete. Auf diese Weise konnte die KI nur mit einer Kopie arbeiten. Vorausgesetzt natürlich, sie würde nicht einfach eigenmächtig meinen Computer durchsuchen. Glücklicherweise tat sie das nicht.
Im Januar, als ich Claude Cowork damit beauftragte, nahm meine Kopie des PDF-Ordners 308 Dateien auf. Mittlerweile sind es 447 Dateien. Was ich möchte, ist, dass Work in diesen Ordner eindringt, die Dateien anhand ihres Inhalts identifiziert und ordnet - und nicht nach Dateityp.
Ich werde Ihnen den Prozess sowie das erläutern, was ich mit ChatGPT Work gemacht habe. Bleiben Sie bis zum Ende dran - denn ich habe einige interessante Schlussfolgerungen sowie ein großes Anliegen.
Arbeite an meinen Dateien
Zur Einstimmung habe ich ChatGPT Work gestartet und es auf meinen Testordner verweisen lassen. Das macht man unten beim Eingabefeld.

Als Erstes fragte ich ChatGPT Work: „Was können Sie mir über diesen Ordner sagen?“ Die Antwort kam ziemlich schnell und war recht klar. Sie enthielt Details zur Anzahl der PDF-Dateien, zum Speicherplatzbedarf, zur Anzahl der Seiten, zu den Hauptthemen sowie dazu, wie viele Dateien verschlüsselt sind - und noch viel mehr. Bisher läuft alles gut.

Es wurde außerdem darauf hingewiesen, dass eine Menge Duplikate gefunden wurden. Claude Cowork hatte das nicht getan. Einige dieser Duplikate existierten bereits zu der Zeit, als ich diesen Test mit Cowork durchgeführt habe. Das spricht also für Work.

Es wurde besser. Ich bat Work, die Duplikate aufzulisten. Beachten Sie den hervorgehobenen Satzteil ganz unten.
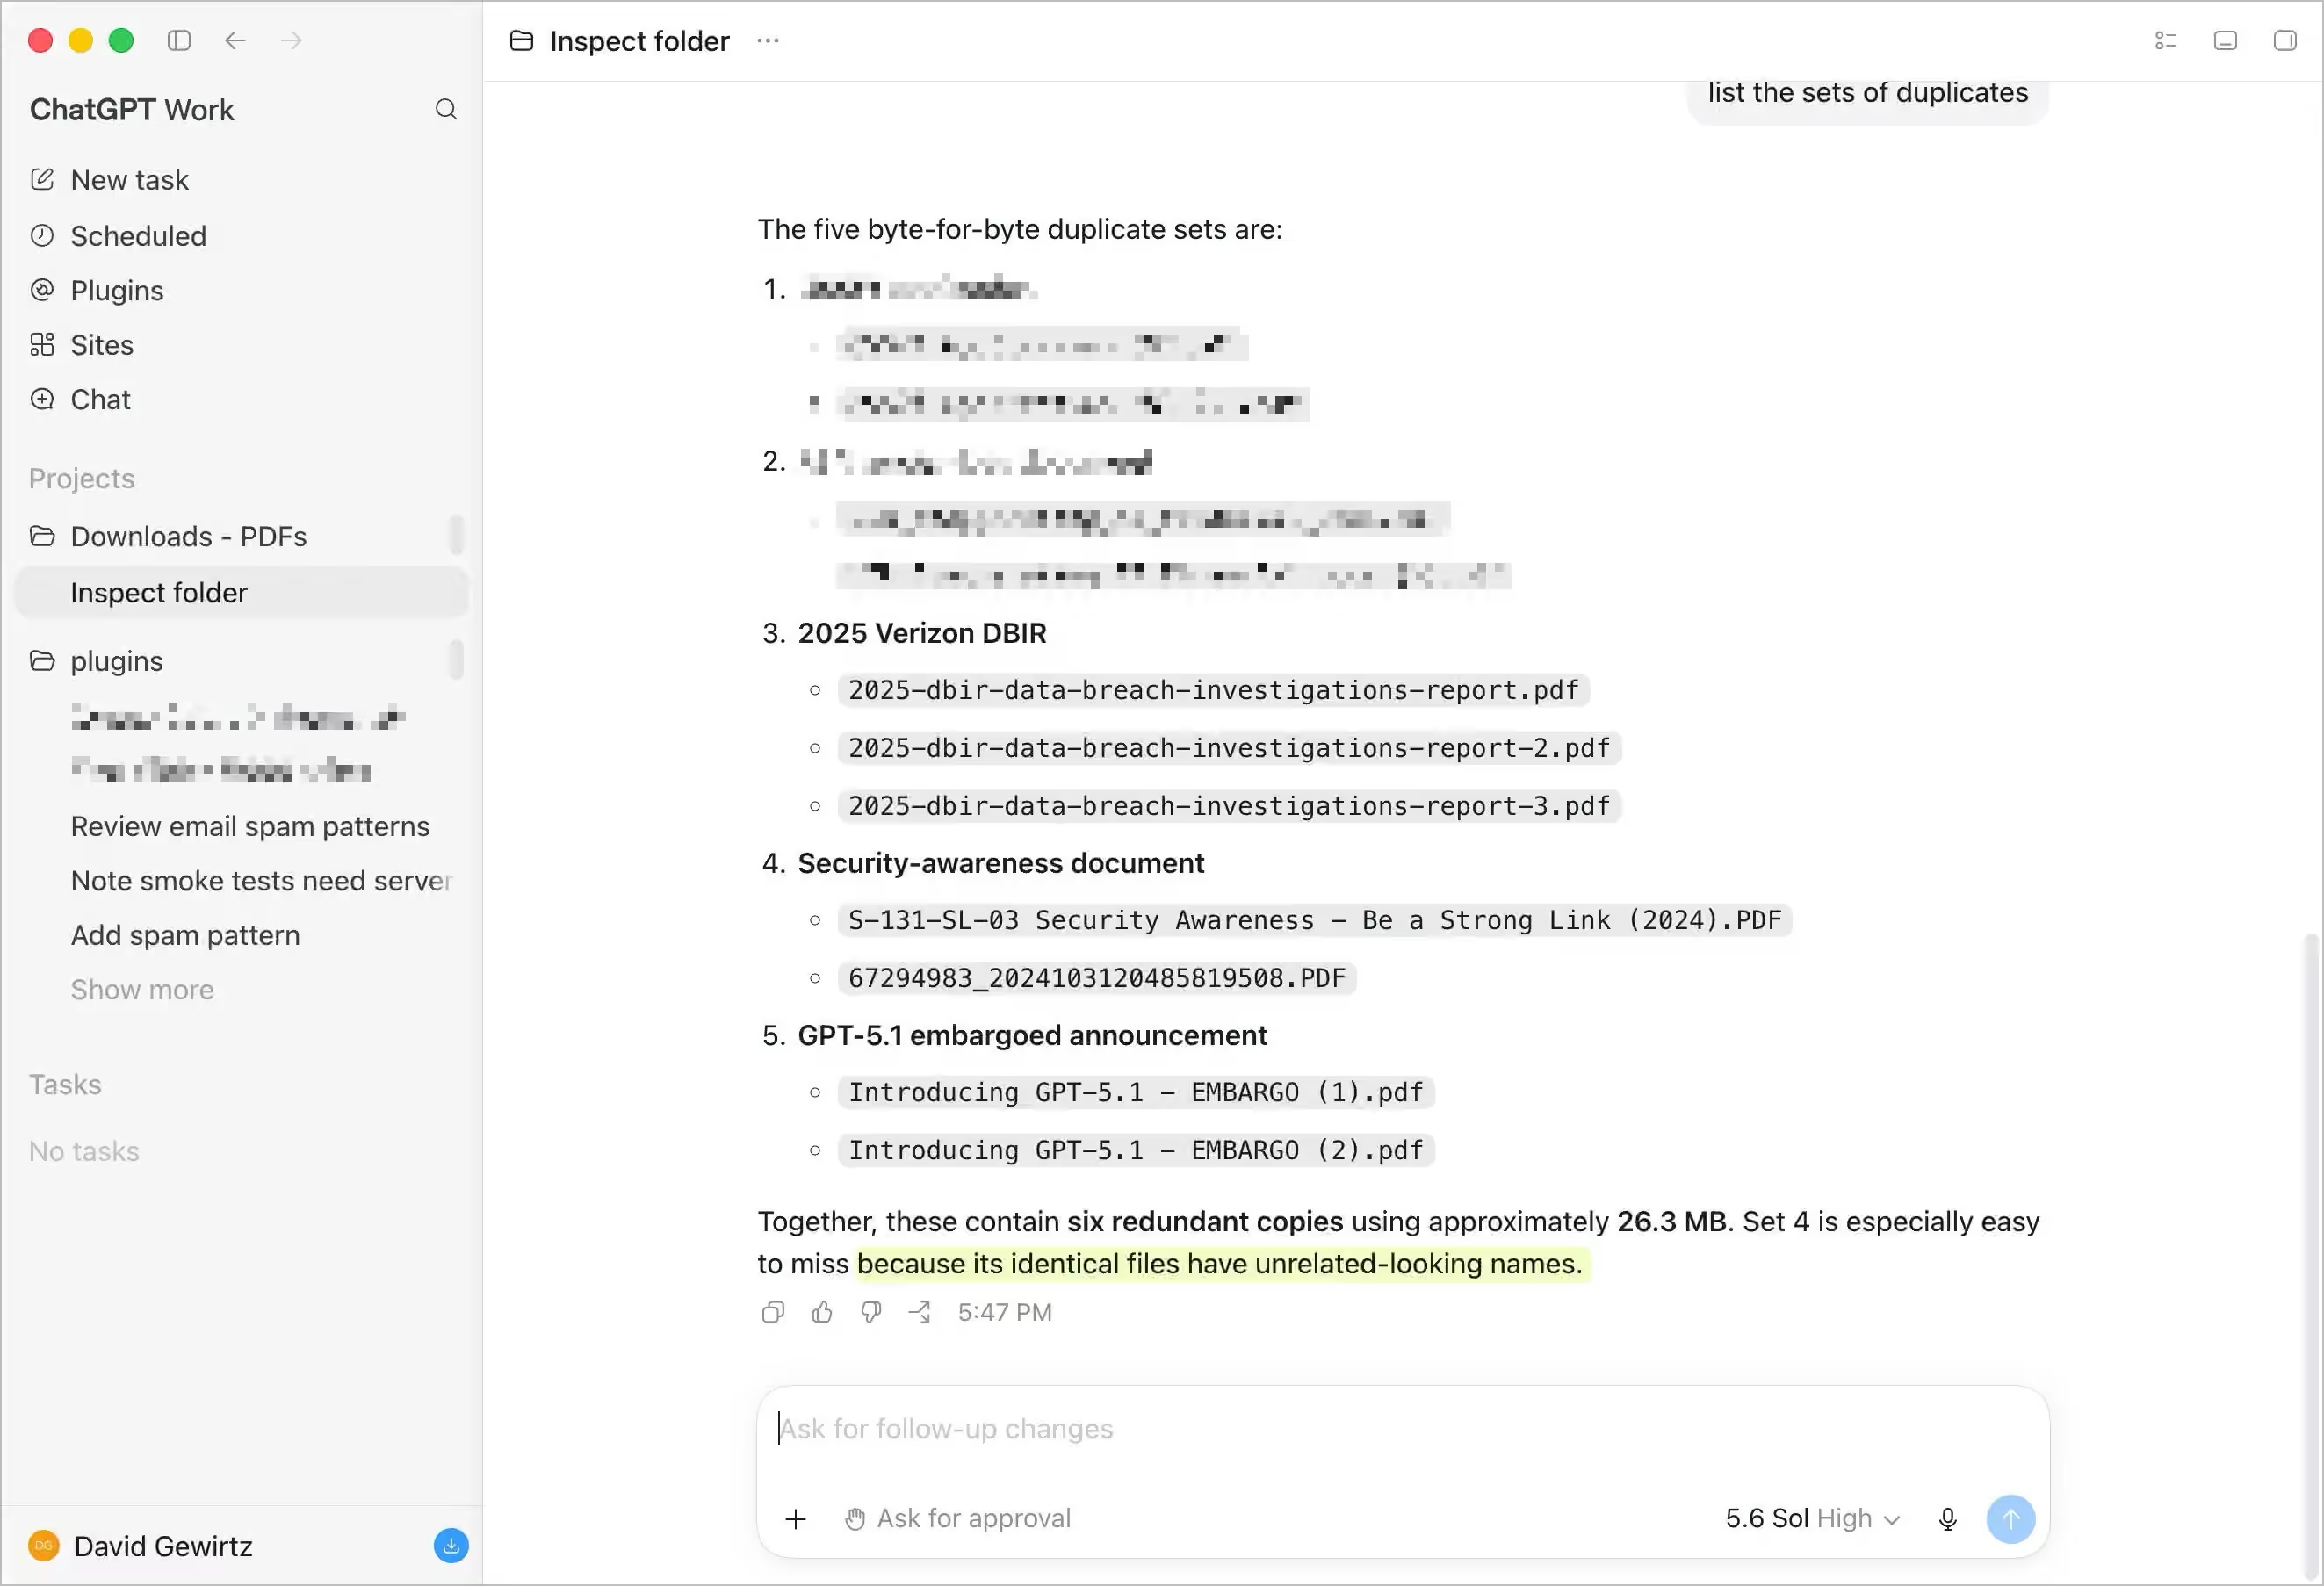
Es hieß: „Set 4 ist besonders leicht zu übersehen, weil seine identischen Dateien Namen haben, die nicht zueinander passen.“ Das bedeutete, dass Work nicht nur die Dateigrößen und -daten verglich, sondern auch einen Teil des Inhalts. Nicht schlecht.
Anschließend bat ich es, die Duplikate zu entfernen - was es sofort tat. Hier gibt es allerdings ein kleines Warnsignal. Ist Ihnen das aufgefallen? Falls nicht, lesen Sie weiter. Ich komme gleich darauf zu sprechen.
Eines, was Claude Cowork getan hatte und was ChatGPT Work nicht tat, war, mich darüber zu informieren, dass ich eine Menge Dateien mit sehr generischen Namen hatte. Ich betrachte das als ein Versäumnis seitens Work. Dennoch gab ich Work denselben Prompt, den ich zuvor an Cowork gegeben hatte, und ließ es laufen.

Während es arbeitete, berichtete Work über die Anzahl der gefundenen Dateien sowie über seine Beobachtungen. Das gefiel mir. Es erklärte außerdem, wie es die Dateien auswählte, die es umbenennen wollte. Ich fand seine Begründung nachvollziehbar.
Die Überprüfung des Inhalts ist abgeschlossen. Ich betrachte einen Namen als generisch, wenn es sich dabei nur um eine Zahl oder einen Code handelt, um einen Standard-Exportnamen wie „Document1“ oder „download“ oder um eine allgemeine Bezeichnung, der das eigentliche Thema fehlt. Nummerierte Rechnungen lasse ich außen vor, da ihre Rechnungsnummern sie eindeutig identifizieren. Ich werde nur die vorübergehend erstellten Seitenbilder bereinigen und anschließend den Vorschlag vorlegen.
Aber dann gab es mir ein Chaos zurück. Es ist lesbar - aber kaum.

Ich bat es, seine Präsentation neu zu formatieren. Aus irgendeinem Grund behielt es diese Präsentation mit schwarzer Schrift auf grauem Hintergrund bei.

Es bedurfte noch einer weiteren Anweisung. Das Ergebnis sieht zwar nicht perfekt aus, ist aber deutlich lesbarer. Wichtiger noch: Die KI hat recht gute Namensvorschläge erstellt, wodurch die Dateinamen an Wert gewannen.

Da mir der Verlauf der Umbenennung gefiel, sagte ich ihm, er solle es durchführen.

Ordner organisieren
Als Nächstes wollte ich, dass Work all diese Dateien in passende Ordner ordnet. Ich begann damit, es zu bitten, die Dateien zu untersuchen und eine grundlegende Taxonomie zu erstellen.

Wie man sieht, begann Work damit, festzulegen, welchen Ansatz es verfolgen würde. Es erkannte richtigerweise, dass die Dateien nicht alle ähnlich waren und dass es für verschiedene Dateien unterschiedliche Ansätze benötigen würde. Genau hier zeigt sich deutlich der „agentische“ Charakter von Work: Es löst Probleme in mehreren Schritten - und zwar im laufenden Betrieb.
ChatGPT Work lieferte mir eine Reihe sinnvoller Kategorien - ähnlich denen, die Claude Cowork im Januar entdeckt hatte. Das Einzige Seltsame in der Zusammenfassung von ChatGPT Work war, dass die Einrückungen zwischen den Kategorien 9 und 10 irgendwie durcheinandergerieten. Kein großer Verlust - aber dennoch merkwürdig.

Ich habe ihm gesagt, es solle dies tun - doch ich möchte darauf hinweisen, was sich am Ende des großen blauen Pfeils befindet. Beachten Sie, dass ich die Einstellung so gewählt habe, dass Work vor der Bearbeitung von Dateien um Genehmigung fragt. Zwar könnte man argumentieren, dass mein Befehl „Los!“ diese Genehmigung darstellte, doch ich erwartete, dass ChatGPT vor Änderungen fragen würde. Bisher hat es das jedoch nie getan. Das bereitet mir Sorgen.

Hier ist der erste Durchlauf. Schön.

Das war ziemlich gut. Ich wollte noch eine kosmetische Anpassung vornehmen. Ich wollte die Zahlen entfernen und die Ampersands durch das Wort „und“ ersetzen.

Und schon ist es erledigt. Fertig!

Zustimmungsbedenken
Ich beginne mit meiner größten Sorge - der Sache, die mich am meisten zögern lässt, dieses Tool zu verwenden. Während der gesamten Dateibearbeitung hat das Tool in keinem Moment um Erlaubnis gebeten, irgendetwas zu tun. Das, obwohl ich die KI niemals aus dem Modus „Um Genehmigung bitten“ herausgenommen habe. Wie Sie sehen können, sollte dieser Modus eigentlich immer um Genehmigung bitten - doch das ist nie geschehen.

Falls etwas verhindern sollte, dass ich dieses Tool nutze, dann ist es das. Es stört mich nicht, die KI in einem Verzeichnis arbeiten zu lassen - das habe ich bereits oft mit Claude Cowork gemacht. Doch Claude fragt mich, ob sie Dateien verschieben oder umbenennen soll, wenn sie größere Änderungen vornehmen will. ChatGPT Work hat hingegen Hunderte von Dateien ohne jegliche Genehmigung verschoben und umbenannt.
Arbeitsgeschwindigkeit
Ich fand, dass Work sowohl langsam als auch schnell war. Lassen Sie mich diese Aussage erläutern. Die reine Arbeitszeit für dieses Projekt betrug 1 Stunde, 13 Minuten und 6 Sekunden - von dem Moment an, als ich Work bat, meine Sachen zu ordnen, bis es fertig war.

Ich bin ziemlich sicher, dass das schneller war, als ich es selbst hätte schaffen können. Wahrscheinlich war es auch schneller als jeder andere Mensch es hätte schaffen können, falls das Projekt an ihn delegiert worden wäre. In diesem Zusammenhang war es also schnell. Doch im Kontext von agentenbasierten KI-Systemen - wenn ich gesehen habe, wie Claude Code riesige Verzeichnisse mit Quellcode-Dateien neu ordnete oder Claude Cowork in recht kurzer Zeit tiefgehende Analysen durchführte - wirkte Work eher langsam.
Eine Stunde und 13 Minuten erscheinen einfach länger, als es eigentlich hätte dauern sollen, bis die KI diese Aufgabe erledigt hatte. Da ich die ganze Zeit dabei war, kam es mir so vor, als würde es ewig dauern.
Ist das ein Nachteil gegenüber ChatGPT Work? Nein. Es hat eine ziemlich gute Arbeit geleistet. Aber es wirkte einfach etwas langsamer als Cowork.
Kosten und Nutzung von KI-Ressourcen
Derzeit habe ich das Plus-Abonnement von ChatGPT, das 20 Dollar pro Monat kostet. Dadurch habe ich Zugang zu Codex und Work - allerdings mit begrenzter Nutzungskapazität für künstliche Intelligenz. OpenAI (sowie andere Anbieter von KI-Diensten) berechnen die Nutzung anhand der Menge an Ressourcen, die man von ihren Servern in Anspruch nimmt. Unterschiedliche Prompts und Aufgaben belasten die Server auf verschiedene Weise. Deswegen ist es schwierig zu sagen, wie viele Aufgaben man einer KI stellen kann, bevor die Nutzungsmöglichkeiten im Rahmen eines günstigeren Abonnements wie meinem eingeschränkt werden.
Trotzdem ist es nicht schlecht. Letzten Monat habe ich mithilfe von Codex eine ziemlich große Menge an Arbeit geleistet, um einem Serverangriff entgegenzuwirken. Zwar hat das System mich ein paar Mal ausgebremst, aber ich habe die Arbeit erledigt. Angesichts der Menge an Arbeit, die ich für meine 20 Dollar geleistet habe, habe ich keine Beschwerden.
Ich war auf jeden Fall neugierig zu sehen, wie viel von meiner „KI-Denkzeit“ ich für dieses Projekt zur Dateiumordnung verbraucht habe.

Wie Sie sehen können, hatte ich zu Beginn des Projekts noch 96 % meiner Verwendungsmöglichkeiten zur Verfügung. Etwa eine Stunde später waren es nur noch 85 %. Ich habe außerdem zwei „Resets“ zur Verfügung - im Grunde genommen Zeitboni, die OpenAI aus ganz unterschiedlichen, eher zufälligen Gründen gewährt.
Im Endeffekt habe ich im vergangenen Monat 11 % meiner Kapazität genutzt. Das bedeutet, ich hätte ungefähr 10 automatisierte Projekte in der Größenordnung meines Dateiumbenennungs-Projekts durchführen können, bevor ich die Kapazität aufgebraucht hätte, für die ich 20 Dollar gezahlt habe. Das ist gar nicht schlecht.
Klar, wenn ich wollte, dass ChatGPT Work ständig läuft, würde ich die verfügbare Kapazität innerhalb eines Tages aufbrauchen. Doch das Umbenennen des Projekts hätte mir zwei Stunden gekostet - zwei sehr langweilige, mühsame und unangenehme Stunden. Um fair zu sein: Die Verwaltungsarbeit hat mich etwa eine halbe Stunde gekostet. Also hat es mir im Endeffekt wirklich 90 Minuten an Arbeitszeit erspart.
Und nehmen wir weiter an, dass jedes ChatGPT Work-Projekt mir weitere etwa 90 Minuten Zeit spart. Ungefähr 10 Projekte, bei jeweils etwa 90 Minuten eingesparter Zeit, ergeben insgesamt 900 Minuten pro Monat - also 15 Stunden. Ganz zu schweigen vom Verschleiß an meinem Handgelenk. Ich finde, das ist ein guter Deal. Ich würde auf jeden Fall 20 Dollar zahlen, um 15 Stunden an zeitraubender Verwaltungsarbeit einzusparen.
ChatGPT Work vs. Claude Cowork
Abgesehen davon, dass es keinerlei Berechtigungsanfragen von ChatGPT Work gab, würde ich sagen, dass die Gesamtqualität ähnlich der von Claude Cowork ist. Cowork erkannte das Problem mit der generischen Dateibenennung; Work hingegen erkannte die Duplikate. Beide haben die von mir gestellte Aufgabe der Neuorganisierung erfolgreich bewältigt.
Cowork hatte anfangs einige Schwierigkeiten - aber das war noch in der Forschungsphase. Seitdem habe ich Cowork häufig genutzt; es funktioniert einwandfrei. Auch ChatGPTs Codex-Agenten-Programmier-KI habe ich seit meinem ersten Test viel verwendet - sie hat sich als äußerst produktiv erwiesen.
Sollte man also das eine dem anderen vorziehen? Heute ja. Wenn Sie etwas tun, bei dem viel auf dem Spiel steht und Sie die Kontrolle behalten wollen, dann nutzen Sie Claude Cowork - Punkt. Doch sobald OpenAI das Berechtigungsproblem gelöst hat (und ich bin sicher, dass das sehr schnell geschieht), denke ich, hängt die Wahl davon ab, ob Ihnen OpenAI oder Claude besser gefällt.
Natürlich werde ich über beide Plattformen weitere Projekte durchführen - bleiben Sie also dran. Ich bin sicher, dass ich in den kommenden Wochen und Monaten noch mehr dazu zu sagen haben werde. Und ich bin immer noch ziemlich verärgert darüber, dass OpenAI die Funktionen von ChatGPT Desktop eingeschränkt hat, um stattdessen die Funktion „Arbeit“ in die Codex-App einzubauen. Auch das hoffe ich, wird in den kommenden Monaten korrigiert werden.
Würden Sie lieber die alten ChatGPT-Desktop-Funktionen oder die neuen Work-Fähigkeiten haben? Lassen Sie es uns in den Kommentaren unten wissen.
Sie können meinen täglichen Projektfortschritt in den sozialen Medien verfolgen. Abonnieren Sie unbedingt meinen wöchentlichen Newsletter und folgen Sie mir auf Twitter/X unter @DavidGewirtz, auf Facebook unter Facebook.com/DavidGewirtz, auf Instagram unter Instagram.com/DavidGewirtz, auf Bluesky unter @DavidGewirtz.com sowie auf YouTube unter YouTube.com/DavidGewirtzTV.